trAIder: ein AI-Handelssystem, gebaut wie Produktionssoftware.
trAIder ist unser eigenes AI-gestütztes Handelssystem für US-Aktien. Es bewertet jeden Handelstag tausende Aktien, entscheidet selbst, was gekauft und verkauft wird, und ist darauf ausgelegt, ohne Menschen in der Schleife zu laufen. Wir entwickeln und erproben es seit 2025. trAIder ist eine Anwendung in Entwicklung und Test, die Dritten derzeit nicht angeboten wird; sie ist kein Anlageangebot, und diese Seite sagt nichts über Rendite.
Warum wir es zeigen: trAIder ist unser Labor. Hier sind wir Auftraggeber und Entwickler zugleich, und jeder Fehler trifft uns selbst. Alles, was wir Kunden über Datenpipelines, LLM-Infrastruktur, Modellvalidierung und Betrieb erzählen, haben wir hier zuerst an uns selbst ausprobiert. Und weil wir jedes Ergebnis dokumentieren, steht auf dieser Seite auch, was nicht funktioniert hat.
Stand September 2026: trAIder läuft im Forward-Paper-Trading mit mehreren parallelen Büchern, die jede Nacht automatisch fortgeschrieben werden. Die Anbindung an den Broker ist gebaut und getestet. Ein erster Pilot mit echtem Geld ist vorbereitet und an vorher festgelegte Kriterien gebunden.
Zwei Ansätze, eine Plattform
trAIder hat zwei Generationen. Der erste Ansatz (2025 bis Mitte 2026) versuchte, aus Nachrichten und Kursen mit Reinforcement Learning eine Handelsstrategie zu lernen: Sprachmodelle verwandeln Finanzartikel in strukturierte Merkmale, ein Deep-Q-Learning-Agent lernt daraus Kauf- und Verkaufsentscheidungen. Der zweite Ansatz (seit 2026) ist bewusst einfacher: ein überwacht trainiertes Modell bewertet Aktien anhand von Kursdaten, und der Aufwand steckt in Validierung, Ausführung und Risikokontrolle statt im Modell.
Der erste Ansatz hat die in ihn gesetzten Erwartungen nicht erfüllt. Er hat aber die Plattform hervorgebracht, auf der der zweite läuft, und die meisten Lektionen, die den zweiten tragen. Deshalb beschreiben wir beide.
Ansatz 1: Nachrichten, Sprachmodelle und Reinforcement Learning
Die Idee war, dass ein Agent starke Kursbewegungen erkennen kann, wenn er neben dem Kurs auch weiß, was über ein Unternehmen berichtet wird. Dafür brauchte es drei Dinge: eine Nachrichtenpipeline, die Artikel in maschinenlesbare Merkmale verwandelt, eine Trainingsumgebung für den Agenten und eine Plattform, auf der beides skaliert.
Die Nachrichtenpipeline. Ausgangspunkt ist GDELT, ein Projekt, das weltweit Nachrichten in über 100 Sprachen indexiert, aber aus Urheberrechtsgründen nur Metadaten und URLs liefert. Der News-Data-Loader, in Python geschrieben und als Kubernetes-Jobs betrieben, fragt die GDELT-API ab und verkleinert Zeitfenster automatisch, weil die API pro Anfrage nur 250 Treffer liefert. Anschließend lädt er die Artikel selbst: mit einem echten Chrome-Browser über undetected-chromedriver, weil viele Finanzseiten JavaScript-lastig sind und einfache HTTP-Clients aussperren. Jeder Download wird klassifiziert, bevor er weiterverarbeitet wird: gültiger Artikel, Cookie-Wand, Bot-Challenge, Cloudflare-Fehler, Zugriff verweigert. Cookie-Wände werden über vier Stufen automatisch weggeklickt, von bekannten Consent-Selektoren über eine CMP-unabhängige Overlay-Suche bis zu Iframes. Domains, die dauerhaft blockieren, sperren sich nach fünf Fehlversuchen selbst. Mehrere Downloader-Pods arbeiten parallel und holen sich ihre Arbeit mit SELECT … FOR UPDATE SKIP LOCKED aus PostgreSQL, ohne Koordinationsaufwand und ohne Doppel-Downloads.
Die Roh-HTML-Seiten landen in MinIO, einem S3-kompatiblen Objektspeicher, Metadaten in TimescaleDB, die bereinigten Texte als Parquet in einem Data Lake, der sich mit Apache Drill per SQL abfragen lässt. Bereinigt wird mit einem Sprachmodell: Meta-Llama-3.1-8B-Instruct, AWQ-quantisiert auf INT4, entfernt Werbung, Navigation und Newsletter-Boxen und liefert strukturiertes JSON mit Absätzen, Listen und Tabellen, in denen Zahlen unverändert bleiben müssen. So haben wir 2,65 Millionen Artikel verarbeitet. Die Sprachmodelle laufen als vLLM-Server auf unserer eigenen GPU-Plattform.
Von Artikeln zu Merkmalen. Reinforcement Learning braucht Beobachtungen fester Länge, Nachrichten haben keine. Deshalb werden Artikel nicht als Text, sondern als Merkmalsvektor pro Aktie und Tag verwendet. Zwei Modelle teilen sich die Arbeit: Ein kleines Modell (Qwen2.5-7B-Instruct, AWQ) prüft billig, ob ein Artikel überhaupt über Unternehmensergebnisse oder regulatorische Ereignisse berichtet. Nur dann analysiert ein großes Finanzmodell auf Basis von Llama 3.1 mit 70 Milliarden Parametern den Text: Überraschung positiv oder negativ, Prognose angehoben oder gesenkt, Stärke der Aussage, dazu Tonalität, Werbe-Charakter und Gerüchte-Flags. Alle Antworten sind strikt schemagebundenes JSON, kategorische Werte werden One-hot kodiert, mit vorgeschalteten Prüfungen gegen die häufigsten Fehlinterpretationen. Aus dem Ergebnis entsteht pro Tag und Aktie ein Vektor fester Länge mit zeitlichem Abklingen, der in der Datenbank liegt. Während des Trainings gibt es keine LLM-Aufrufe. Jede Merkmalsgruppe trägt eine Versionsnummer und einen Berechnungszeitpunkt, sodass sich bei einem geänderten Prompt oder Modell nur der betroffene Teil neu berechnen lässt.
Der Agent. Die Trainingsumgebung ist in PyTorch gebaut. Der Agent ist ein Double-DQN mit Experience Replay; als Netz haben wir Mehrschicht-Perzeptrons und eine Conv1D-LSTM-Variante über Zeitfenstern verglichen. Episoden sind Zeitfenster pro Aktie, in denen der Agent kaufen, halten oder verkaufen kann. Die eigentliche Arbeit steckte in dem, was Lehrbücher auslassen: Ausreißer-Kerzen, die das Training dominieren, Belohnungen, die geclippt werden müssen, ein Portfoliowert, der Unter- und Obergrenzen braucht, feste Zufallssaaten für Reproduzierbarkeit, ein Universum-Filter gegen illiquide und strukturell instabile Aktien, und eine Trainings-GUI, die per WebSocket jeden Schritt des Agenten live auf den Chart zeichnet (siehe unten).
Warum wir aufgehört haben. Der Agent lernte die Trainingsdaten, aber nicht den Markt. Auf bekannten Aktien und bekannten Zeiträumen sah er gut aus, auf neuen Aktien lag er nahe Null oder darunter. Acht vorher registrierte Experimente mit verschiedenen Konfigurationen änderten daran nichts. Ein gezielter Gegentest, ein überwacht trainiertes Modell auf denselben Beobachtungen, zeigte dann, dass nicht das Training das Problem war, sondern die Eingangsdaten: Sie enthielten das gesuchte Signal nicht in nutzbarer Stärke, mit oder ohne Nachrichtenmerkmale. Wir haben den RL-Pfad eingefroren und die Nachrichtenpipeline abgeschaltet. Beides steht so in der Dokumentation, mit Datum und Begründung.
Ansatz 2: Einfacheres Modell, härtere Prüfung
Der zweite Ansatz ist ein End-of-Day-System aus vier Stufen, jede mit eigener, versionierter Tabelle in PostgreSQL: Zuerst wird das Anlageuniversum mit dem Wissensstand genau dieses Tages bestimmt. Dann berechnet ein überwacht trainiertes Modell für jede Aktie eine Wahrscheinlichkeit, die als Rangliste dient. Daraus entstehen Kauf- und Verkaufsentscheidungen für den nächsten Handelstag. Zuletzt werden diese Entscheidungen in Orders übersetzt.
Daten. Die Grundlage sind über elf Millionen Tageskurse zu mehr als 6.000 US-Aktien seit 2016, einschließlich der Werte, die inzwischen von der Börse verschwunden sind. Wer nur mit heute noch existierenden Aktien testet, testet mit Überlebenden. Jede Definition, die in eine Berechnung eingeht, ist eine Registry-Zeile mit Parametern und Git-Commit. Jeder Backtest speichert einen Fingerabdruck aller gelesenen Daten und kann seine Eingaben als Snapshot nach MinIO einfrieren, sodass er Monate später bitgenau wiederholbar ist. Als unser Datenlieferant Kurshistorien rückwirkend änderte, hat genau dieser Mechanismus es sichtbar gemacht; die betroffenen älteren Läufe haben wir als nicht verifizierbar markiert statt sie nachträglich zu retten.
Validierung. Die wichtigste Regel in unserer Dokumentation: Ein Backtest verdient sich Paper-Trading, nie einen Live-Einsatz. Wer im Backtest gut aussieht, bekommt ein Paper-Book und muss sich dort mit echten Kursen, aber ohne echtes Geld bewähren, bevor überhaupt über echtes Geld gesprochen wird. Jede Hypothese wird vorher aufgeschrieben, mit den Kriterien, an denen sie scheitern darf, und genau einmal getestet. Die Bewertung ist Walk-Forward: trainiert auf einem Jahr, gehandelt auf dem folgenden, über neun Jahresfenster von 2018 bis 2026, geprüft auf Aktien, die das Modell im Training nie gesehen hat. Gegen jedes Ergebnis laufen Kontrollen: eine zufällige Rangliste mit sechzehn Startwerten, eine Variante ganz ohne Signal, um Verzerrungen in der Testmaschine zu finden, und ein Test mit zeitlich durchgemischten Kursen, der beweist, dass ein Ergebnis von der Reihenfolge der Tage abhängt. Weil die ursprünglichen Daten kein Bärenjahr enthielten, haben wir die Historie bis 2016 zurück nachgeladen. Die Bandbreite möglicher Verluste schätzen wir mit einem Block-Bootstrap über 30.000 simulierte Pfade, und jede Strategie muss auch bei dreifachen Handelskosten stehen.
Ohne Blick in die Zukunft. Labels werden nur zur Bewertung verwendet, nie als Modelleingabe. Ein Modell darf nie auf seinem eigenen Trainingsjahr getestet werden; die Testmaschine verweigert das. Entschieden wird zum Schlusskurs, ausgeführt zur nächsten Eröffnung, weil Nachrichten nach Börsenschluss sonst in die Entscheidung desselben Tages einfließen, ein Fehler, den wir in Ansatz 1 selbst gefunden haben. Kurse werden konsistent um Splits und Dividenden bereinigt. Ein Regressionstest prüft, dass der Modellwert für einen Tag byte-identisch ist, egal ob dieser Tag der letzte in den Daten ist oder mitten in der Historie liegt.
Vom Backtest zum Broker. Die nächtliche Fortschreibung der Paper-Books und der Backtest benutzen dieselbe Funktion für einen Handelstag; ein Abnahmetest verlangt, dass der Live-Ablauf die gespeicherten Backtest-Zahlen exakt reproduziert. Die Broker-Anbindung spricht die Web-API des Brokers über OAuth 1.0a, als eigene Implementierung mit 41 Unit-Tests, in denen auch die Gegenseite nachgerechnet wird. Orders gehen als Market-on-Open in die Eröffnungsauktion, weil deren Preis genau der Preis ist, mit dem das Modell rechnet. Die Transportschicht wiederholt nie von selbst: Ein Timeout ist genau der Moment, in dem die Order schon angenommen sein könnte. Sobald echtes Geld im Spiel ist, gilt der Broker als Wahrheit, nicht das interne Buch. Der Weg dorthin ist eine Leiter mit vier Sprossen und vorher festgelegten Kriterien; ein profitabler Pilot mit drei unerklärten Abweichungen gilt als gescheitert.
Risiko. Vor jeder Order stehen drei unabhängige Kontrollen, die an genau einer Stelle zusammengeführt werden: der Kontomodus, Halts und Risikolimits. Alle sind fail-closed. Der Standardmodus ist aus. Der Live-Modus braucht zwei unabhängige Freigaben, von denen eine für die Oberfläche unerreichbar ist, und wird von einem Datenbank-Trigger blockiert, solange kein vollständiger Satz Limits existiert. Der Notaus ist ein Kubernetes-CronJob mit unmöglichem Zeitplan, der mit einem einzigen Befehl von jedem Rechner mit Cluster-Zugriff ausgelöst wird; ein Gegenstück zum Aufheben gibt es absichtlich nicht. Automatische Halts stoppen Käufe, nie Verkäufe. Die Limits sind so gewählt, dass keines im normalen Betrieb auslöst: Wenn eines regelmäßig anschlägt, ist das ein Fehlerbericht, kein Marktsignal.
Die Oberfläche: trAIder GUI
Ein autonomes System braucht keine Bedienoberfläche, aber eine Beobachtungsoberfläche. Die trAIder GUI ist genau das, und ausdrücklich keine Stelle, an der ein Mensch Entscheidungen des Systems übersteuert. Sie zeigt für jede Aktie und jeden Tag den Kurs, darüber die tatsächlichen Ereignisse als Bänder, den Modellwert als zweites Band, Kauf- und Verkaufsmarker, Haltephasen und den kumulierten Gewinn und Verlust. Treffer, Fehlalarm, verpasstes Ereignis und Verzögerung liest man direkt am Vergleich der beiden Bänder ab. Dazu kommen eine Seite je Paper-Book mit Kennzahlen, Kapitalkurve und Orderbuch, Jahresansichten für alle Backtests von 2018 bis 2026 mit automatischer Zuordnung des jeweils richtigen Out-of-Sample-Modells, und eine Walk-Forward-Ansicht, die die Renditekurven aller Jahresfenster auf einer logarithmischen Achse gegen das Band der Zufallskontrolle stellt.
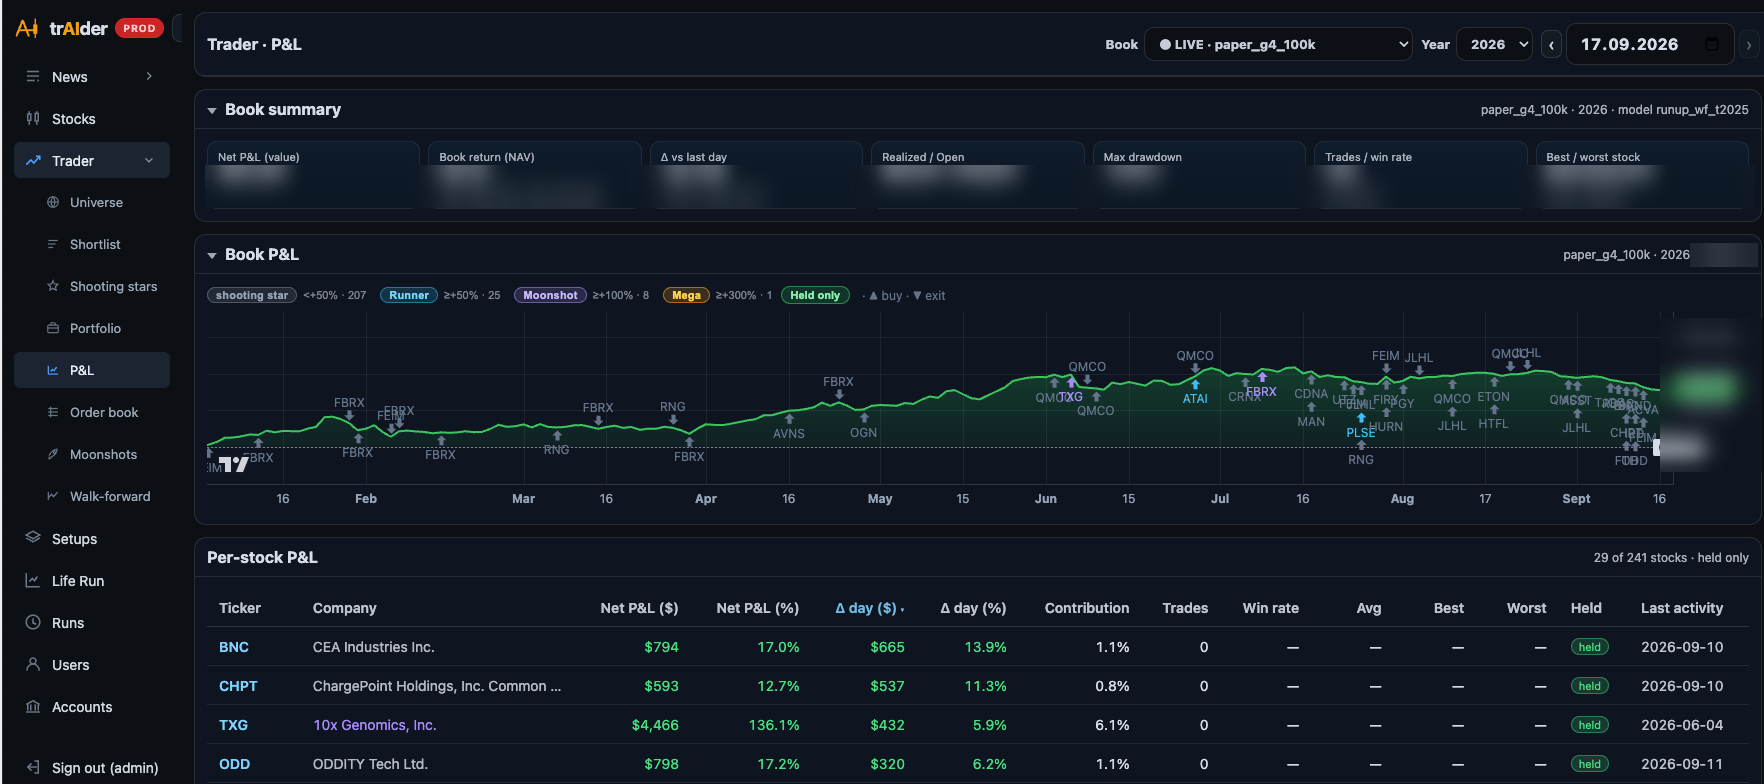
Technisch ist die GUI bewusst schlank: ein FastAPI-Prozess unter Uvicorn auf Python 3.12, serverseitig gerenderte Jinja2-Templates und handgeschriebene ES-Module ohne Build-Schritt, TradingView Lightweight Charts 5 mit einer eigenen Canvas-Ebene für die Bänder und einem zweiten Chart-Pane für den Modellwert, drei WebSocket-Kanäle für Live-Updates aus laufenden Trainings, und psycopg 3 mit Connection-Pool direkt auf PostgreSQL, ohne ORM. Lange Listen werden in Blöcken von 500 Zeilen gerendert und per Infinite Scroll nachgeladen; ein Orderbuch mit rund 3.700 Zeilen pro Jahr lädt seine Seiten nach einer Umstellung auf eine materialisierte CTE mit Lateral-Joins in etwa 16 statt 590 Millisekunden, gemessen auf der Entwicklungsdatenbank.
Die Anmeldung haben wir selbst gebaut, nach einer Abwägung gegen Keycloak, die in der Dokumentation steht: Argon2id für Passwörter, serverseitige Sessions statt JWT, damit sich eine Sitzung sofort widerrufen lässt, Pflicht-TOTP mit zehn einmaligen Wiederherstellungscodes, Sperre nach zehn Fehlversuchen und ein Audit-Log. Die Verbindung ist per TLS mit Zertifikaten aus einer eigenen, per cert-manager automatisch erneuerten PKI gesichert. Die Zugriffsregeln liegen in einer einzigen Middleware, die standardmäßig alles sperrt; ein Test läuft über die echte Routentabelle und prüft, dass jede schreibende Route Administratorrechte verlangt und jeder WebSocket vor dem Verbindungsaufbau authentifiziert. Genau dieser Test hat drei ungeschützte WebSockets gefunden. Und eine Regel ist als Test festgeschrieben: Die Oberfläche kann ein Brokerkonto nur herunterstufen, von live auf Paper auf aus, nie hochstufen.
Der ungewöhnlichste Teil ist ein MCP-Server, der im selben Prozess läuft. Über ihn kann ein AI-Assistent Experimente auflisten und klonen, eine Konfiguration aktivieren, einen Trainingslauf auf dem GPU-Cluster starten, den Fortschritt abfragen und die bewerteten Ergebnisse lesen, im selben Exportformat, das auch der Download-Button der GUI liefert, damit beide nie auseinanderlaufen. Die Leitplanken sind absichtlich hart: Ein Lauf startet nur mit ausdrücklicher Bestätigung, nur für eine vorher aktivierte Konfiguration, und nie, solange ein anderer Lauf aktiv ist. Die Fortschrittsanzeige berechnet ihre Restzeit aus den beobachteten Ankunftsraten und meldet lieber „stalled“ als eine falsche Schätzung.
Die Plattform
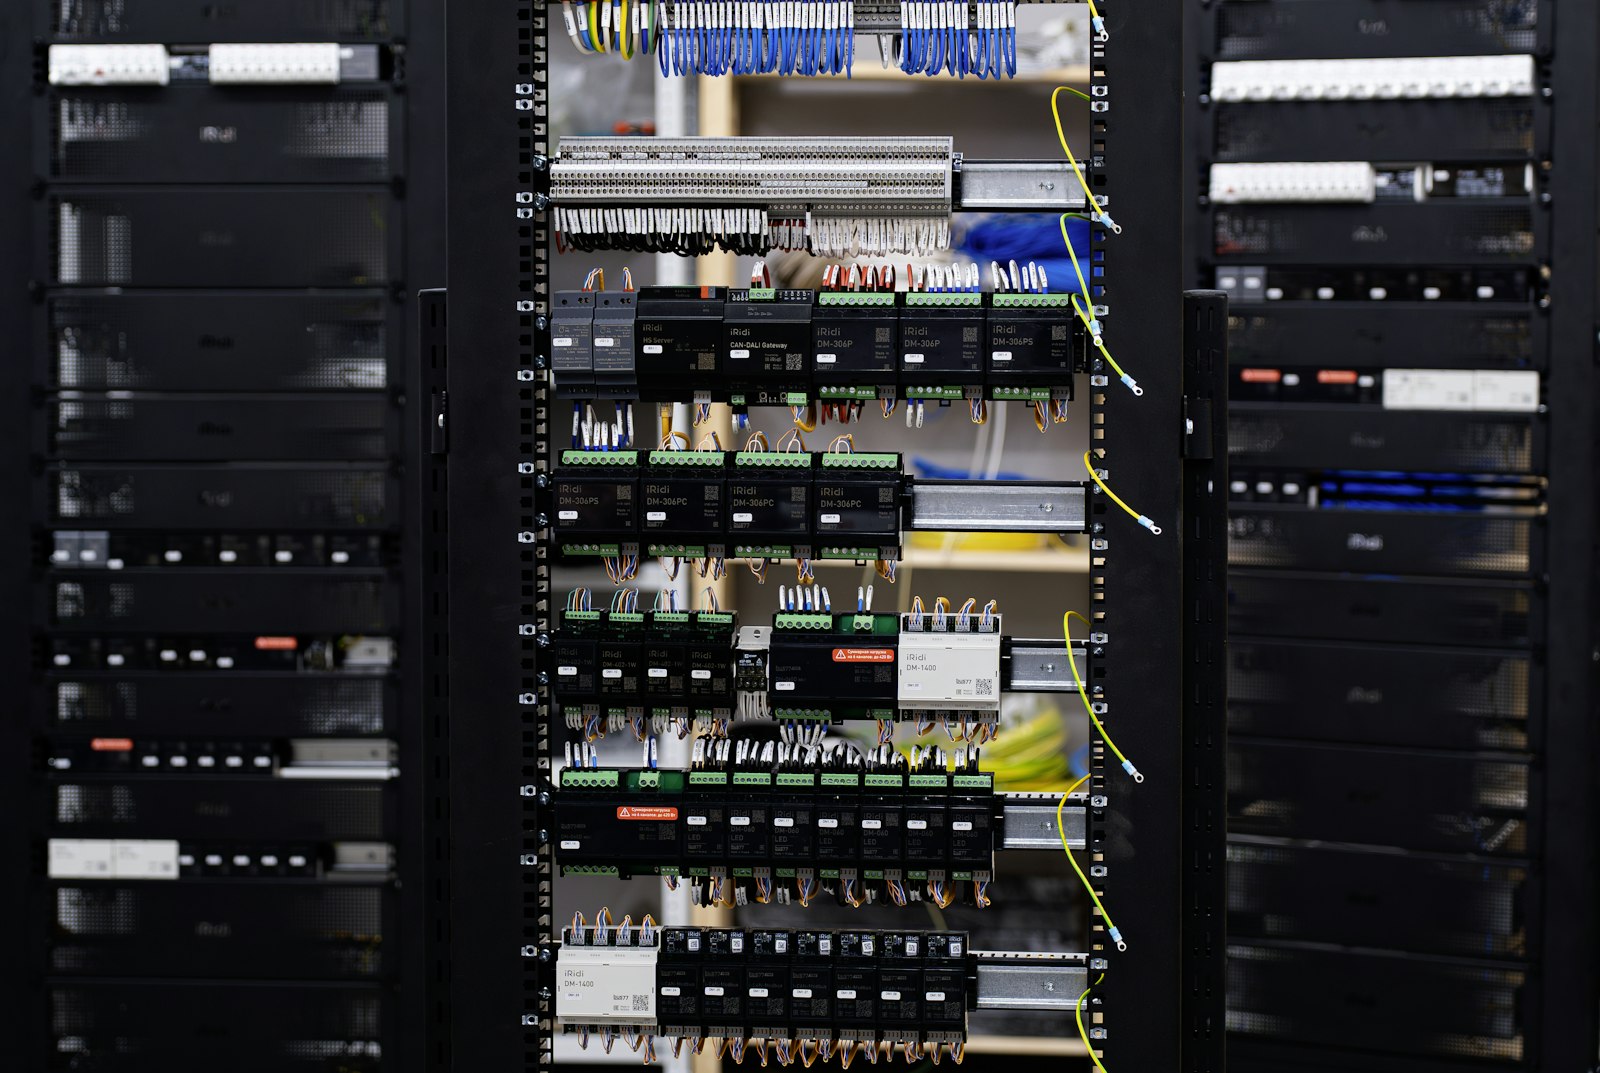
Alles läuft auf eigener Hardware. Der Kern ist ein selbst gebauter GPU-Host mit Intel Core i9 (24 Kerne), 64 GB RAM, NVMe-Speicher und einer GeForce RTX 5080, komplett per Ansible aufgesetzt, von CUDA und NVIDIA Container Toolkit über kubeadm-Kubernetes bis zu Bind9-DNS, ArgoCD und WireGuard-VPN. Fällt der Host aus, wird er mit einem Playbook neu gebaut. Für die großen Sprachmodelle kamen zwei NVIDIA DGX Spark hinzu, die als vLLM-Server unter anderem das quantisierte 70-Milliarden-Parameter-Modell bedienen; dank ihres großen gemeinsamen Speichers passt es unverteilt auf einen Spark. Für die RTX 5080 mussten wir PyTorch für die neue GPU-Architektur (sm_120) zeitweise selbst kompilieren, bevor offizielle Builds sie unterstützten.
Auf Kubernetes deployen wir alles per GitOps: ArgoCD im App-of-Apps-Muster, Helm-Charts pro Anwendung, Datenbankschemata per Flyway-Migration mit getrennten Bootstrap- und Migrations-Apps für Dev und Prod, GPU-Zugriff über den NVIDIA GPU Operator, MetalLB und external-dns für die Erreichbarkeit im Netz. Zugangsdaten liegen in OpenBao und kommen per Vault Secrets Operator in die Pods; im Repository, in Charts oder Images gibt es keine. Der Datenstack: PostgreSQL 17 für alle Zustände (TimescaleDB haben wir nach wiederholten Abstürzen der parallelen Worker wieder entfernt), MinIO für Objekte und Snapshots, Parquet als Austauschformat, Qdrant für Vektoren. Prometheus, Alertmanager, Grafana und Loki liefern Metriken, Alarme, Dashboards und Logs; Alarme kommen aufs Telefon.
Eine Regel aus dem Betriebshandbuch: Ein Alarm, der nie gefeuert hat, ist kein Beweis für Gesundheit. Jeder Alarm braucht eine Positivkontrolle, einmal absichtlich ausgelöst und protokolliert. Wir haben sie eingeführt, nachdem unser Monitoring monatelang „Healthy“ gemeldet hatte, während es selbst nicht mehr aktualisiert wurde. Backups werden nächtlich in eine leere Datenbank zurückgespielt und Tabelle für Tabelle mit dem Original verglichen. Drei Fehler haben wir nur so gefunden.
Was du davon hast
Nichts auf dieser Seite ist die Strategie. Alles auf dieser Seite ist übertragbar: eine LLM-Pipeline, die Millionen Dokumente auf eigener Hardware verarbeitet, Datenpipelines mit nachrechenbarer Herkunft, Validierung mit Kontrollgruppen statt Hoffnung, Sperren gegen Information aus der Zukunft, Systeme, die im Zweifel anhalten, und ein Betrieb, der seine eigenen Alarme testet. Genau das bringen unsere Experten in dein Projekt mit, ob es um Finanzdaten geht oder um etwas ganz anderes.
Technologien
| Bereich | Eingesetzt |
|---|---|
| Sprachen und ML | Python, PyTorch, Double-DQN mit Experience Replay, MLP und Conv1D-LSTM, überwachtes Ranking-Modell, NumPy/pandas |
| Sprachmodelle | Meta-Llama-3.1-8B-Instruct (AWQ INT4), Llama-3.1-basiertes 70B-Finanzmodell (Q4_K_M), Qwen2.5-7B-Instruct (AWQ), vLLM, schemagebundenes JSON |
| Daten | PostgreSQL 17 (zuvor TimescaleDB), Flyway, MinIO (S3), Parquet, Apache Drill, Qdrant, GDELT, SEC EDGAR |
| Pipelines | Kubernetes Jobs und CronJobs, undetected-chromedriver, FOR UPDATE SKIP LOCKED, Thread-Pools gegen vLLM Continuous Batching |
| Plattform | Ansible, kubeadm, NVIDIA GPU Operator, CUDA, ArgoCD (App-of-Apps), Helm, OpenBao + Vault Secrets Operator, MetalLB, external-dns, Bind9, WireGuard |
| Betrieb | Prometheus, Alertmanager, Grafana, Loki, ntfy, getestete pg_dump-Restores |
| Ausführung | Broker-Web-API über OAuth 1.0a (eigene Implementierung), Market-on-Open, fail-closed Risk Gate |
| Oberfläche | FastAPI, Uvicorn, Jinja2, ES-Module ohne Build-Schritt, TradingView Lightweight Charts 5, WebSockets, psycopg 3, Argon2id, TOTP, MCP-Server (FastMCP, Streamable HTTP) |
| Hardware | Intel Core i9-13900K, 64 GB DDR5, NVMe, GeForce RTX 5080, 2× NVIDIA DGX Spark |
trAIder befindet sich in Entwicklung und Erprobung durch die Deep Data Ocean GmbH und wird Dritten derzeit nicht angeboten. Nichts auf dieser Seite ist eine Anlageberatung, eine Aufforderung zum Handel oder eine Aussage über Erträge.